评估
使用 cappy test 建立离线评估,比较 Agent 的回答与参考 SQL,并查看不同模型的准确性、成本和耗时。
cappy test 是 Cappy 的离线评估:你准备一组问题和参考 SQL,在发布上下文后或 CI 中重复运行,检查 Agent 是否仍能正确回答。固定测试集可以帮助你判断一次规则、指标定义或模型调整带来了改进,还是让原本正确的问题出错。
上下文建议承担在线评估,从真实使用中的错误和反馈发现测试集没有覆盖的问题。把这些问题补进测试集,再用评估检查修改效果,可以让上下文随着使用持续改进。
cappy test
cappy test 读取当前项目 tests/ 目录中的 YAML 文件,向 Agent 提问,并将回答对应的数据与参考 SQL 的查询结果比较。每个用例对应一个问题;评估可以同时比较多个模型。
创建测试用例
下面的 my-project 代表你的项目文件夹,里面已经有 config.yaml 和同步后的上下文。示例假设项目连接了一张订单表 orders,每行是一笔订单,amount 是需要求和的收入金额。使用自己的项目时,问题、表名和字段应与实际业务定义一致。
写入问题和参考 SQL
创建 tests/total_revenue.yml:
name: total_revenue
prompt: 所有订单的总收入是多少?
sql: |
  SELECT SUM(amount) AS total_revenue
  FROM orders
项目有多个数据库时,在用例顶层加上 database: warehouse,将 warehouse 换成订单表所在的连接名。完整字段见配置参考。
运行评估
运行前置条件
- 在已运行的 Cappy 实例中配置模型。
- 将要评估的上下文发布到项目。Agent 使用已发布的上下文和数据库连接。
- 评估使用账号可访问的第一个项目。实例有多个项目时,建议只授予评估账号访问目标项目的权限。
- 默认连接
http://localhost:5005。使用其他实例时,将下面的地址换成实际地址,在当前终端执行。
export BACKEND_URL='https://cappy.example.com'在项目根目录运行评估。默认运行本地 tests/ 下的所有用例。
cappy test执行结束后,终端显示每个用例的状态,详细结果写入 tests/outputs/:
my-project/
├── config.yaml
├── RULES.md
└── tests/
    ├── total_revenue.yml
    └── outputs/
        └── results_20261029_170000.json
results_*.json 由评估自动生成,保存回答、查询与比较数据,供后面的结果页面读取。
检查工具调用(可选)
以评估项目根目录 RULES.md 中的新增规则为例。
- 新增规则“收入问题既未指定时间范围,也未要求统计全部订单时,先询问时间范围”,并发布到项目。
- 为这条规则新建测试用例
tests/ambiguous_revenue_period.yml。 - 在用例中配置
type: tool_call断言,检查 Agent 是否调用clarification工具向用户追问。评估会记录追问并结束本次回答。
name: ambiguous_revenue_period
prompt: 收入是多少?
assertions:
  - type: tool_call
    tool: clarification
将前面的 tests/total_revenue.yml 更新为下面的完整内容。
name: total_revenue
prompt: 所有订单的总收入是多少?
sql: |
  SELECT SUM(amount) AS total_revenue
  FROM orders
assertions:
  - type: tool_call
    tool: execute_sql
运行评估时,这个用例检查两件事。
sql计算预期的总收入,用来核对 Agent 回答中的数据。assertions检查 Agent 的工具调用记录,要求它至少调用一次execute_sql工具执行 SQL 查询。
两项都通过,这个用例才通过。
选择模型和用例
选择模型
在项目根目录创建 tests/config.yaml,在 models 中列出要评估的模型。
models:
  - deepseek:deepseek-flash
  - deepseek:deepseek-v4-pro
threads: 4
k: 3
comparison:
  rtol: 0.00001
  atol: 0.00000001
  decimals: 2
运行 cappy test,每个用例会在上述两个模型上各运行三次。其他配置项见配置参考。
选择用例
使用 -s 或 --select 运行一个或多个用例。可以填写用例的 name、不含扩展名的文件名,或 tests/ 下的子目录名。
假设 tests/sales/ 下有两个用例。
| 用例文件 | 文件中的 name |
|---|---|
revenue.yml | total_revenue |
period.yml | ambiguous_revenue_period |
# 按 name 选择
cappy test -s total_revenue

# 按不含扩展名的文件名选择
cappy test --select revenue

# 按子目录名选择
cappy test -s sales
前两条命令都运行 tests/sales/revenue.yml,第三条运行 tests/sales/ 下的全部用例。
多个选择项用逗号分隔。下面的命令按 name 选择这两个用例。
cappy test -s total_revenue,ambiguous_revenue_period找不到名称时,终端会列出可选用例。
配置参考
| 配置项 | 填写方式与默认值 |
|---|---|
| 用例文件 | 在 tests/ 下为每个问题建一个 YAML 文件,例如 tests/total_revenue.yml。 |
name | 用例名称,用于选择用例和查看结果。默认取不含扩展名的文件名。 |
prompt | 必填。发给 Agent 的问题。 |
sql | 计算预期结果的参考 SQL。要核对数据,须填写非空查询。 |
database | 运行参考 SQL 的连接名,对应项目 config.yaml 中的 databases[].name。单个连接时可省略,多个连接时必填。Agent 根据问题和上下文选择要查询的数据。 |
assertions | 可选的工具调用断言列表。所有断言都要通过,同时填写 sql 时,数据比较也要通过。 |
| 工具调用断言 | 以下字段写在用例的 assertions 列表项中。 |
type | 必填。填写 tool_call。 |
tool | 必填。要检查的工具名,必须与调用记录完全一致。 |
args | 可选。省略时匹配该工具的任意参数。填写时须为非空对象,只检查列出的字段,例如 {database_id: warehouse} 匹配指定连接。嵌套对象逐层匹配,列表和其他值必须相等。 |
min_count | 至少要匹配的调用次数。正整数,默认 1。 |
| 运行配置 | 写在 tests/config.yaml 中,对整次运行生效。省略此文件时使用默认值。 |
models | 参与评估的模型列表,每项格式为 provider:model_id。默认 [],使用实例默认模型。 |
threads | 同时运行的测试数。正整数,默认 1。按数据库的查询承载量,以及模型账号的并发、每分钟请求数和 Token 限额设置。 |
k | 每个用例在每个模型上的运行次数。正整数,默认 1。 |
| 数值比较 | 以下字段写在运行配置的 comparison 下,控制浮点数的舍入和比较误差。 |
decimals | 比较前浮点数舍入保留的小数位数。非负整数,默认 2。 |
rtol | 数值近似比较的相对容差。非负数,默认 0.00001。 |
atol | 数值近似比较的绝对容差。非负数,默认 0.00000001。 |
比较时先按 decimals 处理浮点数。舍入后的值完全相等时通过,否则按 atol + rtol × |预期值| 允许的差值比较。
例如,默认配置下,预期值为 100000、实际值为 100001 也会通过。若要求保留两位小数后的值完全相等,将 tests/config.yaml 中的 comparison.rtol 和 comparison.atol 都设为 0。
评估成本
费用优先按组织设置中配置的模型价格计算,其次使用内置价格。无法计算费用时,单次运行的 cost 为 null,汇总按 0 计。
结果中的 Token、费用和耗时统计 Agent 回答阶段。数据核对另有模型调用和执行开销。
如何判断结果
以总收入用例为例。
- 将
prompt发给 Agent,记录回答和工具调用。 - 执行参考
sql得到预期数据,并从 Agent 的查询结果中取得与回答对应的实际数据。 - 比较实际数据与预期数据,并检查配置的工具调用断言,保存结果和差异。
例如,参考 SQL 返回 330,Agent 回答对应的数据也是 330,数据比较结果为 match。实际数据为 331 时,默认配置下会显示 values differ。
比较以参考结果的列名和数据为准。SQL 写法可以不同,比较会忽略结果的行顺序,并将可识别的格式化数值转成数字。浮点差异按 comparison 配置处理。
终端结果
k = 1 时,每行包含用例名称、模型、通过状态、结果说明、Token、费用、耗时和工具调用次数。
| 结果说明 | 含义 |
|---|---|
match / match (approximate) | 实际数据与参考结果一致,或数值差异在配置容差内 |
both empty | 实际数据与预期数据均未返回行 |
values differ | 实际值与预期值不同,可在详情中查看差异 |
row count: … vs … | 实际数据与预期数据的行数不同 |
missing columns: … | 实际结果缺少参考结果要求的列 |
actual is empty / expected is empty | 实际数据或预期数据为空,另一边有数据 |
error | 执行或数据核对报错,需查看具体错误信息 |
tool_call: … / missing tool_call: … | 工具调用满足或未满足断言中的名称、参数和次数要求 |
no verification data | 同时要求 SQL 和断言,却未取得数据核对结果,用例失败 |
no verification | 没有执行数据比较;即使状态显示通过,也不能算作正确性评估通过 |
k = 1 且配置多个模型时,Performance by Model 汇总各模型的通过率、费用和平均耗时,Pass / Fail by Test and Model 按用例对比各模型的结果。
k > 1 时,每行汇总同一个用例在同一个模型上的多次运行,多个模型之间仍有用例对比表。结果 JSON 中的指标如下,以三次运行中两次通过为例。
| 指标与 JSON 字段 | 含义与示例 |
|---|---|
pass@1(pass_at_1) | 通过次数占全部运行的比例。示例为 2/3,约 66.7%。 |
pass@k(pass_at_k) | 至少一次通过为 1,全部失败为 0。示例为 1。 |
pass^k(pass_hat_k) | 全部通过为 1,有一次失败即为 0。示例为 0。 |
同一个用例和模型的全部运行都通过时,该行的 Status 才显示通过。
结果文件
tests/outputs/results_*.json 保存以下信息。
| 字段 | 内容 |
|---|---|
results | 每次运行一条记录,包含用例、模型、attempt、状态、费用和执行详情。attempt 从 1 开始。 |
summary | 全部运行的通过数、失败数、Token、费用和耗时汇总 |
by_model | 按模型汇总的结果,用于比较不同模型 |
pass_metrics | 按用例和模型分组的重复运行指标,以及整体平均值 |
两个模型、两个用例、各运行三次,results 就有 12 条记录。单条记录的 details 保存回答、参考 SQL、工具调用、实际数据、预期数据及差异。执行报错时,数据字段可能为空。
在浏览器查看评估
运行一次评估后,在同一个项目目录执行:
cappy test server浏览器打开 http://localhost:8765,读取当前项目 tests/outputs/ 下的结果。右上方选择结果文件,可以查看不同运行批次。
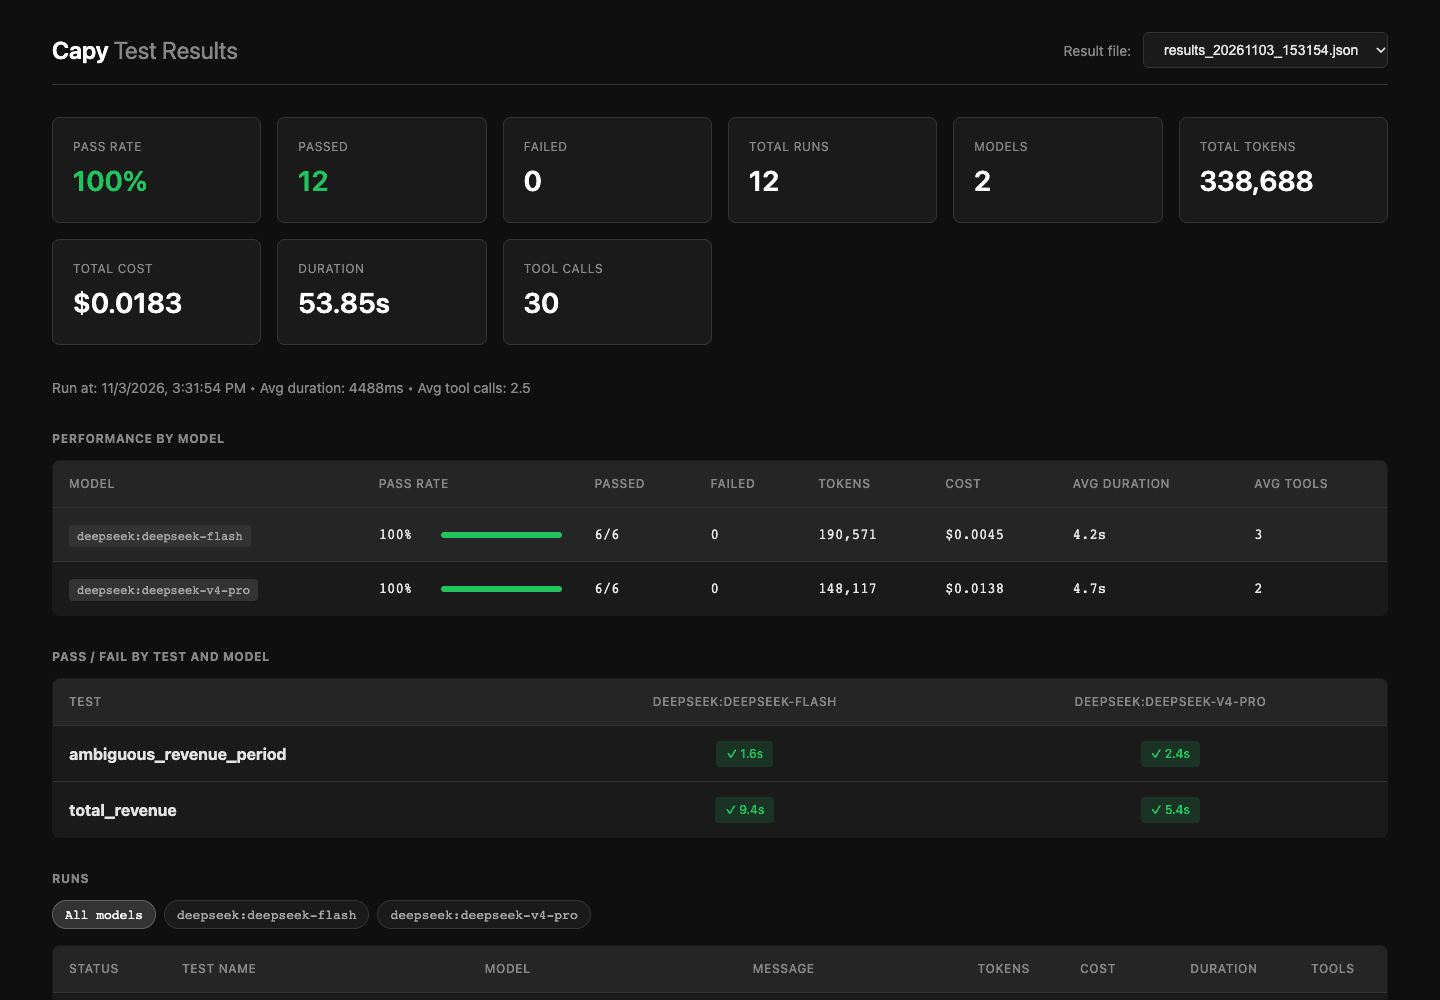
页面上方汇总通过率、测试数、Token、成本和耗时。运行包含多个模型时,还会显示模型汇总和用例对比表;点击模型可以筛选结果。
重复运行时,网页对比表只显示每个用例和模型的最后一次记录;查看全部尝试及通过率,请使用结果 JSON 中的 results 和 pass_metrics。
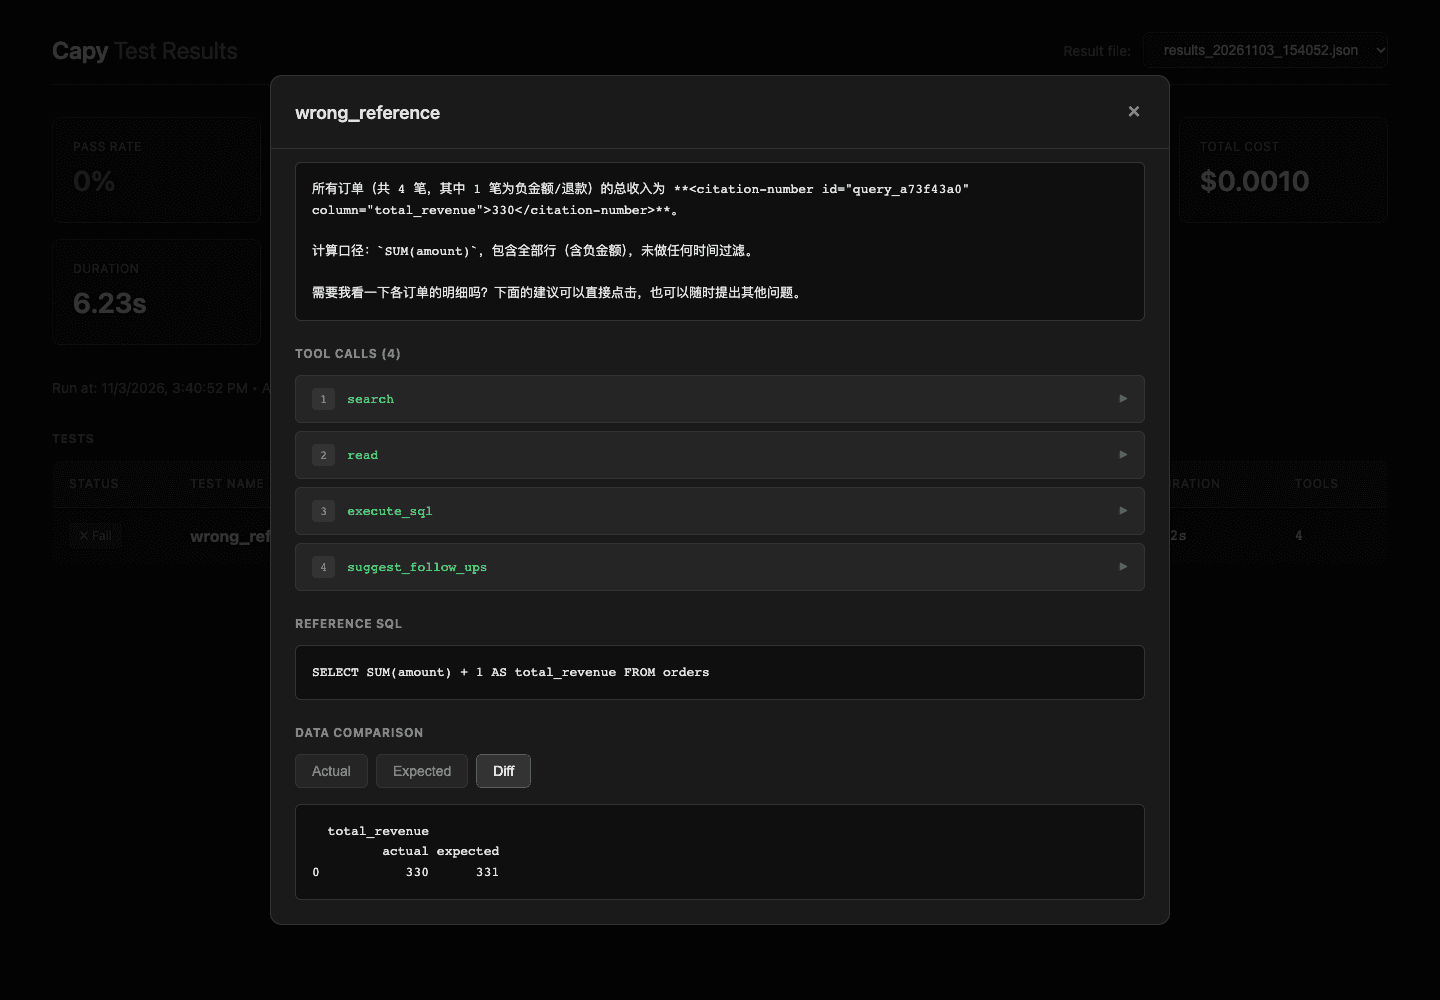
点击一个用例,查看完整回答、参考 SQL、工具调用及参数、实际数据与预期数据。失败用例的差异视图可以帮助定位具体哪一列、哪一行不一致。
为展示差异,下面的截图使用专门构造的失败用例 wrong_reference。它的参考 SQL 在 SUM(amount) 上加 1,因此预期值为 331,Agent 实际返回 330。
编写有效的评估
- 覆盖团队经常提出的问题,并补充空结果、时间边界、多表关联等用例。
- 将
tests/与上下文一起纳入 Git。修改规则、指标、表关系或模型后重新评估。 - 通过
tests/config.yaml中的k重复运行,对比每次运行的结果和重复运行指标。
在 CI 中运行
CI 任务需要能访问已运行的 Cappy 实例。在 CI 的环境变量中配置以下内容,账号密码通过 CI 的凭据管理注入。
| 环境变量 | 配置内容 |
|---|---|
BACKEND_URL | Cappy 实例地址,默认 http://localhost:5005 |
CAPPY_USERNAME | 评估账号的登录邮箱 |
CAPPY_PASSWORD | 评估账号的密码 |
评估使用账号可访问的第一个项目。多项目实例为 CI 账号只授予目标项目的访问权限。
在已检出的项目根目录运行评估。
cappy test任一次运行失败,或配置、用例 YAML 无效时,命令以非零状态退出。
未发现用例或 -s / --select 未匹配时,命令会以 0 退出,且不生成本次结果文件。CI 还需确认本次结果文件存在,并包含预期用例。